Локальный запуск нейросетей перестал быть уделом гиков. Сегодня любой ПК или ноутбук с 8–16 ГБ памяти способен тянуть языковые модели, генерацию картинок и распознавание речи — без интернета, без подписок и без передачи данных на чужие серверы. Разбираем, какие нейросети стоит ставить на свой компьютер в 2026 году, сколько для этого нужно «железа» и с чего начать новичку.
Что такое локальная нейросеть и зачем она нужна
Локальная нейросеть — это модель, веса которой хранятся на вашем диске, а все вычисления выполняются процессором или видеокартой вашего компьютера. Никаких облачных сервисов, лимитов запросов и «токенов за подписку». После установки интернет нужен только для скачивания новых моделей.
Главные причины перейти на локальный ИИ:
- Приватность. Документы, код и личные переписки не покидают ваш компьютер — всё обрабатывается на месте.
- Экономия. Нет ежемесячных платежей за API и подписки: платите один раз за «железо».
- Автономность. Модели работают без интернета — в самолёте, на даче, на закрытом контуре компании.
- Отсутствие лимитов. Генерируйте сколько угодно — никаких ограничений по количеству запросов.
- Гибкость. Доступ к сотням открытых моделей, тонкая настройка параметров, подключение своих баз знаний.
Что учесть перед выбором нейросети
Всё упирается в три вопроса: какие задачи решаете, какое у вас «железо» и какой порог входа вам комфортен. Ключевая характеристика для любого локального ИИ — объём памяти. Для языковых моделей решает связка видеопамяти (VRAM) и оперативной памяти: именно от неё зависит, какая модель «влезет». Для генерации изображений решает почти всё только VRAM.
Сколько памяти нужно: ориентиры по размеру моделей
Размер модели принято измерять в миллиардах параметров (обозначение вида «7B»). Чем больше параметров, тем умнее модель — и тем больше памяти ей нужно. Квантизация (сжатие весов, например форматы GGUF Q4) уменьшает требования примерно в 2–4 раза с минимальной потерей качества.
| Размер модели | Примеры | Видеопамять (квант Q4) | Оперативная память | Типичные задачи |
|---|---|---|---|---|
| 1–4B | Phi-3 Mini, Gemma 3B, Qwen 3B | от 4 ГБ | 8 ГБ | Быстрые ответы, простые тексты, слабые ПК |
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen 7B | 6–8 ГБ | 16 ГБ | Универсальный чат, тексты, анализ документов |
| 13–14B | Qwen 14B, Phi-4, DeepSeek 14B | 10–12 ГБ | 16–32 ГБ | Программирование, сложные тексты |
| 30–35B | Qwen 32B, MoE-модели | 16–24 ГБ | 32 ГБ | Код, аналитика, глубокие рассуждения |
| 70B+ | Llama 3.3 70B | 24 ГБ и выше | 64 ГБ | Максимальное качество, требует серьёзной видеокарты |
Ориентир на 2026 год: практический минимум для комфортной работы с современными моделями — 8–12 ГБ видеопамяти. Владельцы Mac на чипах Apple Silicon в выигрыше: у них единая память процессора и графики, поэтому Mac с 32–64 ГБ памяти тянет модели, недоступные ПК со схожей ценой.
Можно ли обойтись без видеокарты
Да. Все основные инструменты умеют считать на процессоре. Модели до 8B параметров работают на современном CPU вполне сносно — это нормально для обучения, письма и экспериментов. Но будьте реалистичны: генерация картинки на чистом процессоре занимает минуты вместо секунд, а ответ длинной модели растягивается в разы. Видеокарта — это ускоритель, а не обязательное условие.
Лучшие нейросети для текста и чата
Для работы с языковыми моделями важна не сама модель, а «оболочка» — программа, которая её скачивает, запускает и даёт удобный интерфейс. Вот проверенные варианты под разные сценарии.
LM Studio — лучший выбор для новичка
Приложение с графическим интерфейсом, которое делает локальный ИИ простым до элементарного: встроенный поиск по Hugging Face, ползунки настроек, чат с историей, поддержка документов (PDF, DOCX, TXT) и локальный API-сервер. Автоматически определяет ваше «железо»: с видеокартой работает на GPU, без неё — на процессоре. Минусы — установщик весит больше 500 МБ, а графический интерфейс потребляет заметные ресурсы. Если нужен «локальный ChatGPT» за пять минут — начните отсюда.
Ollama — стандарт для разработчиков и автоматизации
Самый популярный инструмент в своей нише: команда ollama run скачивает модель и сразу открывает диалог в терминале. Поднимает локальный сервер с OpenAI-совместимым API, поэтому к нему подключаются боты, скрипты, редакторы кода и сотни сторонних приложений. Поддерживает NVIDIA, AMD, Apple Metal и Vulkan, а с недавних пор умеет запускать модели даже в агентах для кода. Порог входа повыше — без терминала никуда, зато для серверов и встраивания в свои проекты это штатный вариант.
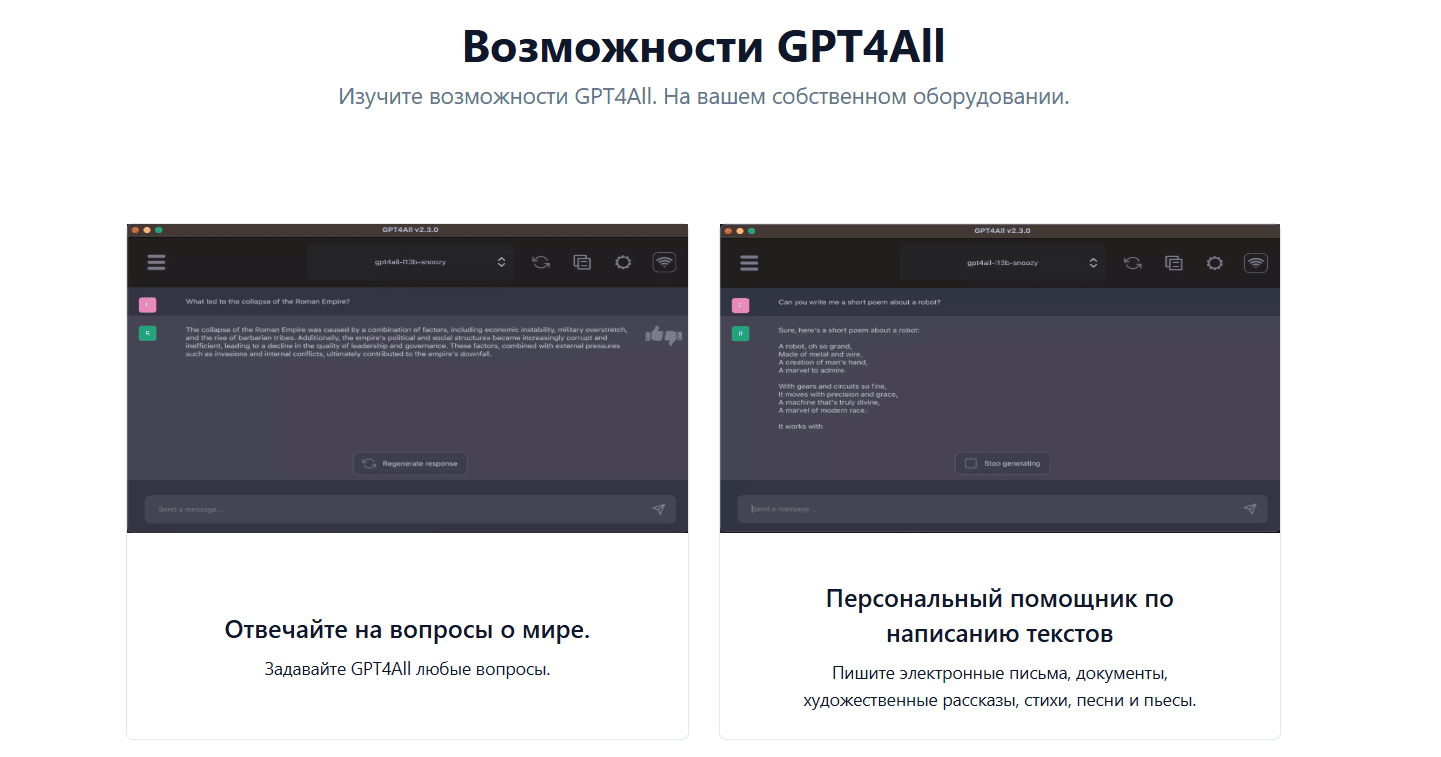
GPT4All — самый простой вариант для слабого ПК
Лёгкое бесплатное приложение, которое работает даже без мощной видеокарты. Есть каталог моделей, чат с памятью диалога, анализ локальных документов. Уступает конкурентам в возможностях — редкие обновления, нет поддержки новых протоколов, — зато ставится обычным установщиком и прощает слабое «железо». Минимум: 8 ГБ оперативной памяти.
Jan и Text Generation WebUI — для тех, кто хочет больше контроля
Jan — открытый аналог LM Studio с каталогом моделей, локальным API и поддержкой MCP: молодой, быстро развивается, но иногда сыроват. Text Generation WebUI — браузерный интерфейс с поддержкой разных форматов моделей (GGUF, GPTQ, AWQ) и расширениями; порог входа выше, зато гибкость максимальная. Оба варианта бесплатны и подходят энтузиастам.
Какие языковые модели скачивать: Llama, Qwen, Mistral, DeepSeek
Выбор модели от программы почти не зависит — все основные оболочки поддерживают одни и те же открытые модели:
- Llama 3 / 3.1 (Meta) — универсальная классика: общий чат, тексты, рассуждения. Версия 8B — золотая середина для домашнего ПК.
- Qwen (Alibaba) — сильна в мультиязычности, программировании и математике. Семейство Coder — одно из лучших для работы с кодом, версия 14B требует 12–16 ГБ видеопамяти.
- DeepSeek — модели с упором на логику и рассуждения; дистиллированные версии R1 хорошо работают локально на умеренном «железе».
- Mistral — экономичные и быстрые европейские модели, отлично подходят для бизнес-задач и анализа документов.
- Phi-3 / Phi-4 (Microsoft) — компактные модели с крепкой логикой; работают даже на ноутбуке с 4–8 ГБ памяти.
- Gemma (Google) — лёгкие и качественные модели, хороший выбор для старта.
Для русского языка лучше всего показывают себя Qwen, Llama и Gemma — их стоит проверять первыми, скачивая варианты с 4-битной квантизацией.
Лучшие нейросети для генерации изображений
ComfyUI — максимум контроля
Узловой конструктор, где пайплайн генерации собирается из блоков вручную. Даёт полный контроль и точную повторяемость результата, поддерживает Stable Diffusion, SDXL, Flux и видеомодели. Базовый workflow на SD 1.5 идёт от 6 ГБ видеопамяти, SDXL комфортно — от 12 ГБ, Flux в сжатом FP8 — от 16 ГБ. Порог входа самый высокий среди оболочек: на понимание нод уйдёт вечер, зато это единственный активно развивающийся инструмент для сложных схем с ControlNet, LoRA и апскейлом.
Fooocus и InvokeAI — проще, чем кажется
Fooocus — самый простой вход в генерацию картинок: до первой фотографии меньше трёх щелчков мыши, модель SDXL скачивается сама. Минимальные требования — 4 ГБ видеопамяти на NVIDIA не старше GTX 10-й серии и 8 ГБ оперативной (при 4 ГБ обязательно включённый файл подкачки). InvokeAI — редактор с удобным интерфейсом и менеджером моделей, поддерживает десятки моделей семейств SD 1.5, SDXL и Flux.
Локальные нейросети для аудио и видео
Whisper.cpp — переписанная на C++ локальная версия распознавания речи от OpenAI. Быстро транскрибирует аудио, переводит на разные языки, работает в реальном времени и подходит даже старым ноутбукам: достаточно 8 ГБ оперативной памяти и пары гигабайт на диске. Для монтажа и замены лиц в видео стандартом остаётся DeepFaceLab, но он требует 16 ГБ ОЗУ, видеокарты NVIDIA от 4 ГБ и терпения — проще объяснять его как профессиональный инструмент, а не «поставил и поехал».
Сводная таблица: какой инструмент выбрать под задачу
| Инструмент | Задача | Порог входа | Минимальное «железо» | Кому подойдёт |
|---|---|---|---|---|
| LM Studio | Чат, тексты, документы | Низкий | 8 ГБ ОЗУ | Новички, домашнее использование |
| Ollama | Чат, API, автоматизация | Средний | 8 ГБ ОЗУ, от 10 ГБ диска | Разработчики, серверы |
| GPT4All | Чат, документы | Низкий | 8 ГБ ОЗУ, 20 ГБ диска | Слабые ПК, Windows |
| Jan | Чат, ассистенты | Низкий | 8 ГБ ОЗУ | Сторонники open-source |
| ComfyUI | Генерация изображений | Высокий | 6–12 ГБ VRAM, 16 ГБ ОЗУ | Дизайнеры, продакшн |
| Fooocus | Генерация изображений | Низкий | 4 ГБ VRAM, 8 ГБ ОЗУ | Новички в артах |
| Whisper.cpp | Расшифровка аудио | Средний | 8 ГБ ОЗУ, 5 ГБ диска | Конспекты, субтитры |
Частые вопросы о локальных нейросетях
Какие нейросети можно запустить на обычном компьютере?
На любом современном ПК или ноутбуке с 8 ГБ оперативной памяти запустятся компактные модели до 8B параметров: Phi-3, Gemma, Mistral 7B, Llama 3 8B. Для 14B–32B моделей нужна видеокарта с 12–24 ГБ видеопамяти или Mac с большой единой памятью.
Работают ли локальные нейросети без интернета?
Да, полностью. После загрузки модели на диск все вычисления идут на вашем устройстве — тексты, картинки и расшифровки создаются офлайн, данные никуда не передаются.
Законно ли запускать нейросети локально?
Да, если соблюдать лицензию конкретной модели. Большинство открытых моделей (Llama, Mistral, Phi, Gemma) разрешают личное и коммерческое использование на своих условиях — например, у лицензии Stability AI бесплатное коммерческое использование действует при годовой выручке до миллиона долларов. Уточняйте условия в описании модели перед использованием в бизнесе.
Сколько места занимают модели на диске?
Одна языковая модель — от 3 до 8 ГБ и больше, модели для генерации изображений — от 4 до 15 ГБ каждая. Под запасы на коллекцию моделей, LoRA и результаты закладывайте десятки, а лучше сотни гигабайт на быстром NVMe-диске.
Чем локальная нейросеть отличается от облачной?
Облачная модель мощнее и умнее топовых локальных, зато локальная бесплатна в использовании, работает офлайн и не отправляет ваши данные наружу. Для конфиденциальных документов, приватного чата и стабильных ежедневных задач локальный ИИ в 2026 году — уже полноценная альтернатива.
Выводы: с чего начать прямо сегодня
Оптимальный маршрут для новичка: поставьте LM Studio, скачайте модель на 7–8B параметров в квантованном формате (например, Llama 3.1 8B или Qwen 7B) и просто начните переписываться — так вы за вечер поймёте, что реально тянет ваше «железо». Разработчикам и тем, кто хочет встроить ИИ в свои сервисы, — Ollama с её API. Для генерации изображений — Fooocus на слабом ПК или ComfyUI на карте с 12+ ГБ видеопамяти.
Главное правило: начинайте с малых моделей и наращивайте размер, пока скорость ответов остаётся комфортной. Локальный ИИ в 2026 году — это не компромисс, а рабочий инструмент с нулевой стоимостью владения после покупки «железа». 🚀